
멀티컷 댄스 다인물 교체 스킬: 두 명을 각자 다른 캐릭터로, 원본 음악은 그대로
여러 컷으로 된 댄스 영상에서 두 명 이상을 각자 지정한 인물 시트로 바꾸는 스킬입니다. 구간별 무음 생성, 원본 음성 합성, 주·보조 테이크를 겹친 타임라인과 어긋난 구간 대체까지 AI 에이전트가 진행합니다.
- 실행
- YouViCo AI 에이전트 · 채팅창에 스킬 파일 첨부
- 난이도
- 고급
- 소요 시간
- 준비 10분 + 에이전트 작업 대기(구간 수에 비례)
결과물
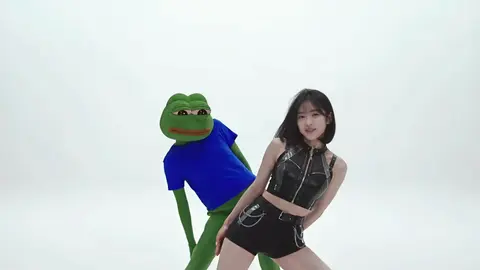
컷이 바뀌고 두 사람의 거리와 크기가 달라져도, 왼쪽과 오른쪽 인물이 각자 정해진 시트로 끝까지 유지됩니다.
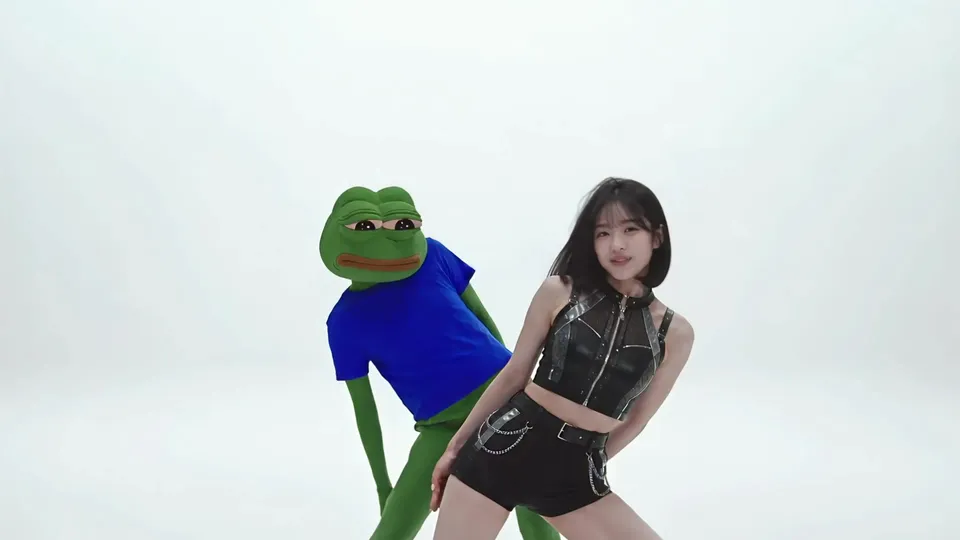
결과 2초. 두 사람이 붙어서 추는 컷. 왼쪽은 개구리 캐릭터, 오른쪽은 인물 시트의 캐릭터로 바뀌었습니다.
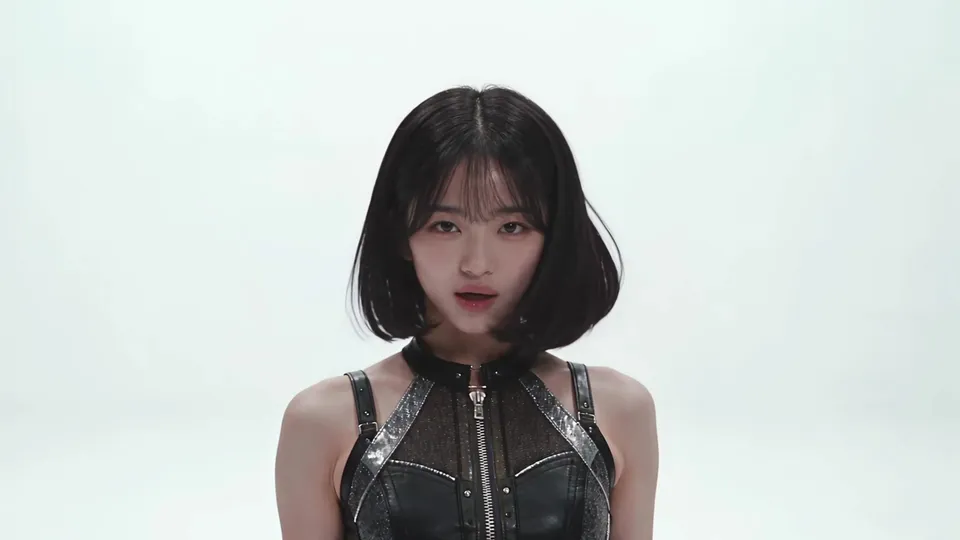
결과 5.3초. 한 사람만 나오는 클로즈업 컷도 시트의 얼굴과 의상을 따라갑니다.
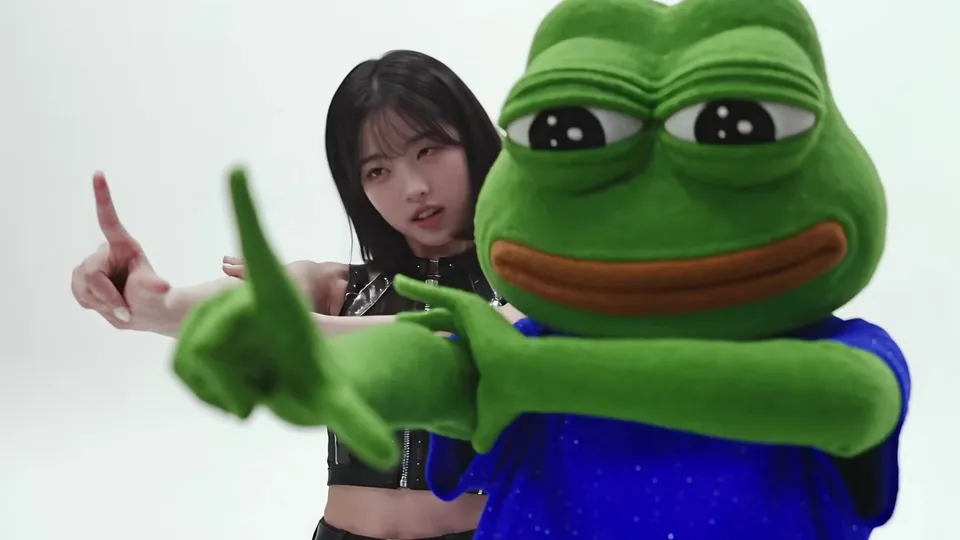
결과 6.2초. 두 사람이 카메라를 가리키는 컷. 스킬에 적힌 사례로는 4.733–6.7초가 보조 테이크로 바꿔 넣은 구간입니다.
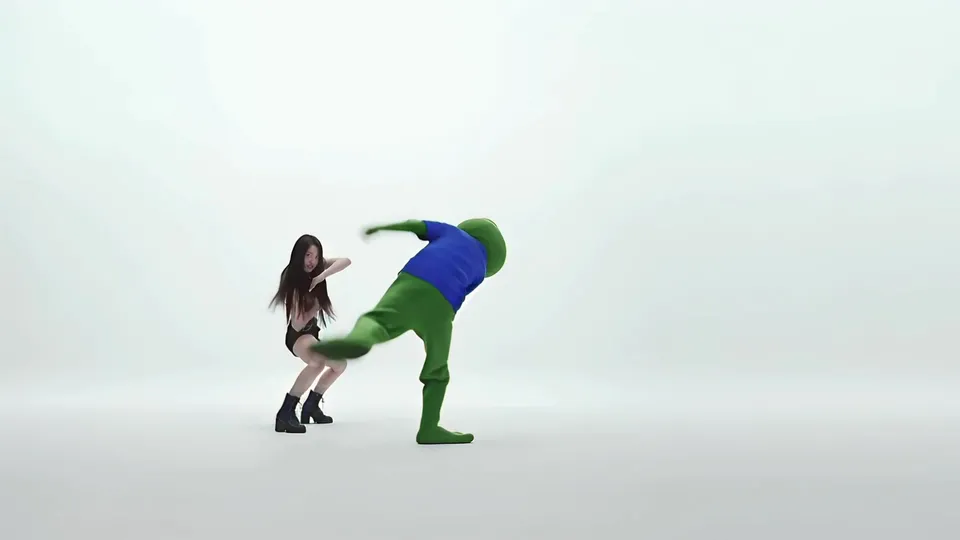
결과 11초. 멀리서 잡은 와이드 컷에서도 좌우 배정과 동작이 원본과 같습니다.
다운로드
AI 에이전트 채팅창에 첨부할 스킬 파일입니다.
준비물
스킬에 필요한 것은 이것뿐입니다. 에이전트에게 요청하기 전에 프로젝트에 올려 두세요.
원본 댄스 영상 1개
video여러 컷으로 된 댄스나 퍼포먼스 영상. 컷 구성, 안무, 음악은 원본 그대로 남습니다. 위의 소스용 영상을 써도 됩니다.
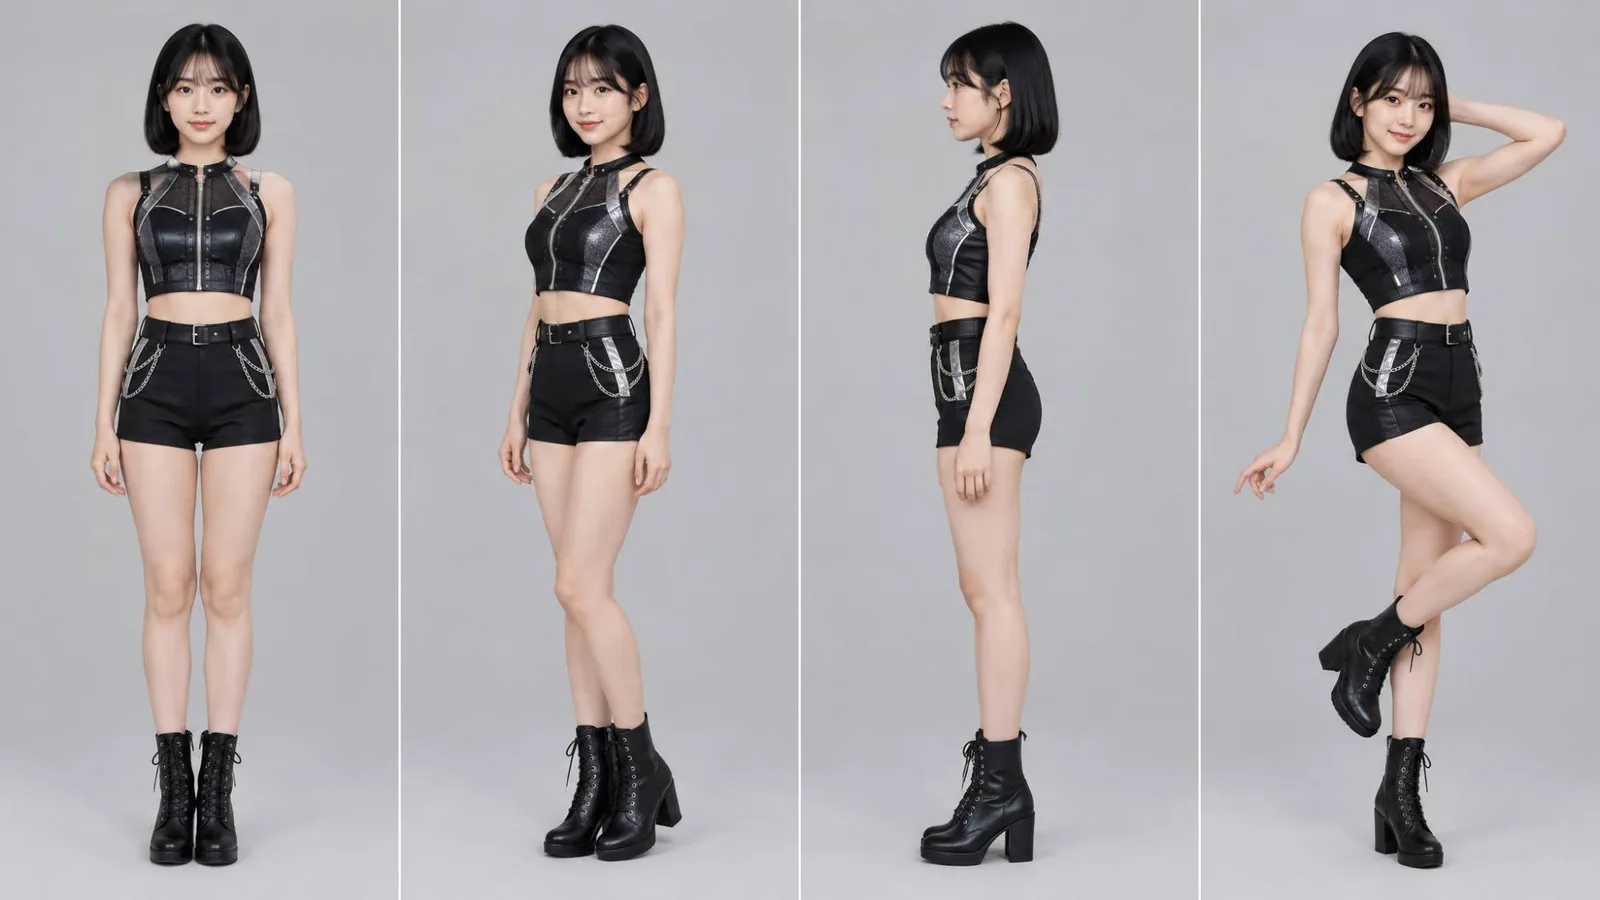
photo_a인물 시트
바꿀 사람마다 시트를 한 장씩 준비합니다. 예시는 오른쪽 사람을 이 인물 시트로 바꿨습니다.
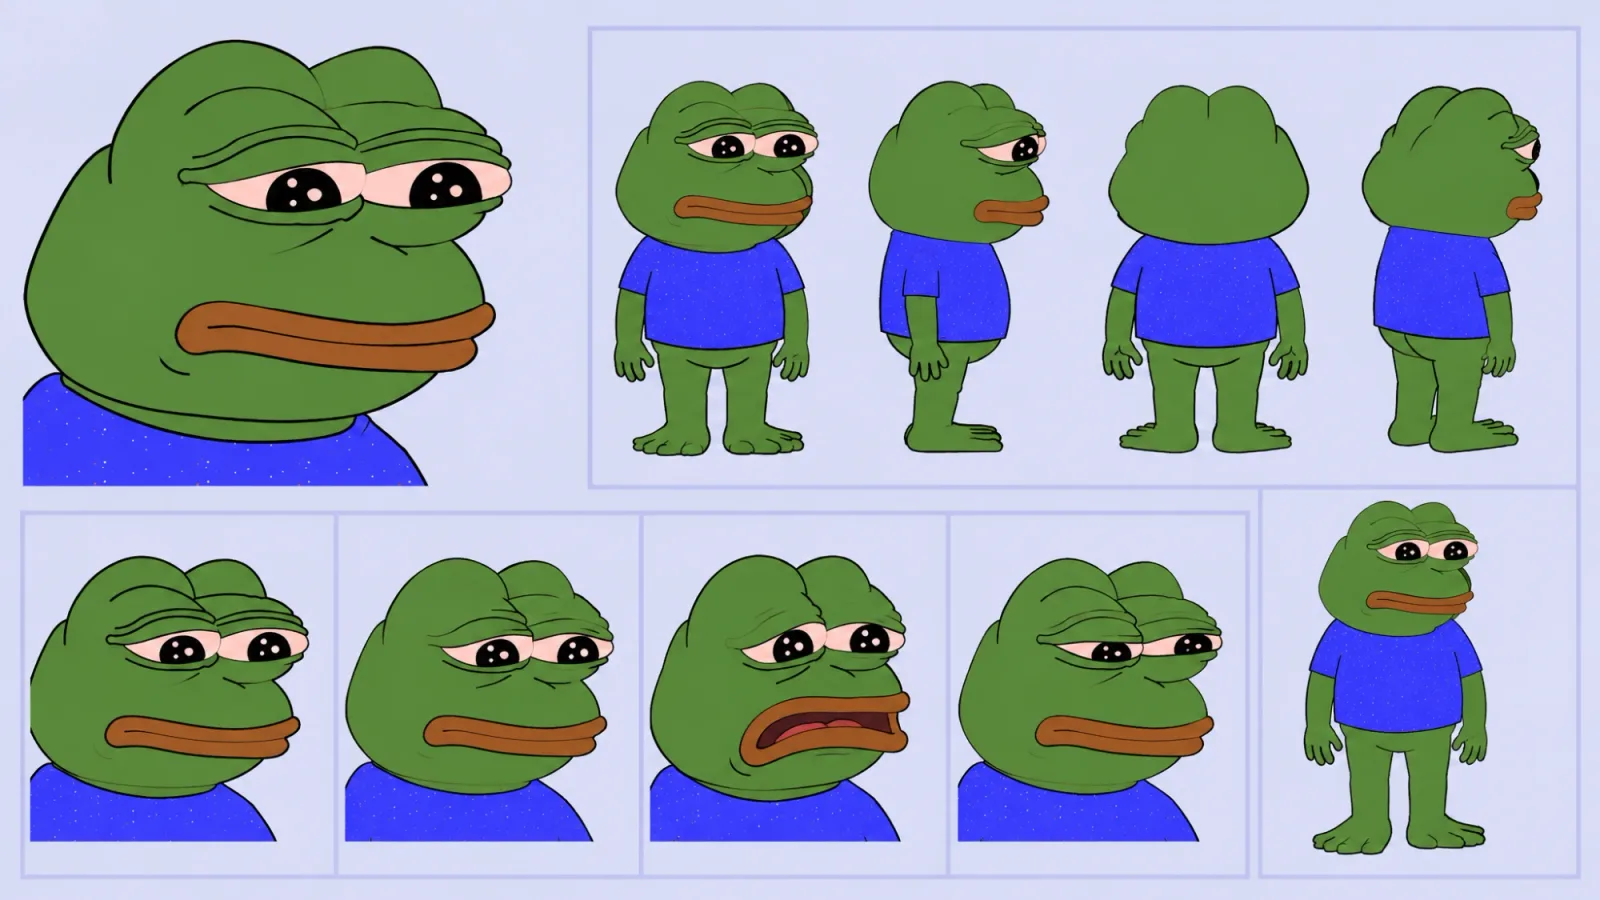
photo_b캐릭터 시트
사람이 아닌 캐릭터도 됩니다. 예시는 왼쪽 사람을 정면, 측면, 뒷모습, 표정을 한 장에 담은 이 캐릭터 시트로 바꿨습니다.
여러 컷으로 이어지는 댄스 영상에서 두 사람을 각각 다른 캐릭터로 바꾸는 스킬입니다. 한 사람은 인물 시트의 캐릭터로, 다른 한 사람은 개구리 캐릭터로 바꾸는 식입니다. 컷 순서와 길이, 안무, 카메라는 원본 그대로 두고, 음악은 원본 음성을 편집기에서 다시 붙입니다. 한 사람만 바꾸는 댄스 영상 인물 교체를 여러 사람, 여러 컷으로 넓힌 버전입니다.
이 스킬이 만드는 것
- 원본과 같은 16:9 1080p 영상. 예시는 15초입니다.
- 사람마다 정해 둔 시트로 바뀝니다. 컷이 바뀌어 두 사람의 위치가 달라져도 배정을 컷마다 적어 두고 따라갑니다.
- AI 생성은 소리 없이 하고, 음악과 음성은 원본 클립의 소리를 그대로 씁니다.
- 결과는
{프로젝트}_인물교체_완성본_원본음성_vN.mp4이름으로, 검토 필요 상태로 들어옵니다.
실행하는 법
- 프로젝트에 원본 댄스 영상과 바꿀 사람 수만큼의 시트를 올립니다. 원본이 없으면 위에서 받은 소스용 영상을 써도 됩니다.
- YouViCo 데스크톱 앱에서 제목 표시줄의 AI 버튼을 누르거나 Ctrl/Cmd+Shift+A로 AI 에이전트를 엽니다. AI 에이전트는 Windows·macOS 데스크톱 앱에서 쓸 수 있습니다.
- 스킬 파일을 AI 에이전트 채팅창에 첨부합니다. 채팅 입력칸 왼쪽 아래의 클립 버튼으로 파일을 고르면 됩니다. 자주 쓸 거라면 스킬 화면의 SKILL.md 가져오기로 내 스킬에 저장해 두세요. 스킬이 에이전트와 어떻게 동작하는지는 스킬이란?에 정리했습니다.
- 누구를 어떤 시트로 바꿀지, 모델과 예산을 함께 적어 보냅니다. 모델과 예산을 적지 않으면 에이전트가 먼저 묻습니다.
이 스킬로 댄스 영상의 두 사람을 바꿔줘.
왼쪽 사람은 개구리 캐릭터 시트로, 오른쪽 사람은 인물 시트로.
모델은 Seedance 2.5, 예산은 1,500 크레딧 안에서. 원본 음악은 그대로.
에이전트가 먼저 묻는 것
이 스킬은 예시와 똑같은 영상을 다시 만드는 게 목적이 아닙니다. 내 영상을 만들 수 있게, 에이전트는 시작하기 전에 아래를 한 번에 묻고 요청에 이미 적은 것은 다시 묻지 않습니다. “알아서 해줘”라고 하면 예시와 같은 기본값으로 진행합니다.
- 바꿀 사람은 몇 명이고, 각자 어떤 캐릭터(시트)로 바꿀까요?
- 원본에서 누가 누구인지 위치나 의상으로 알려 주세요.
- 의상이나 소품을 바꾸고 싶은 것이 있나요? 기본: 시트의 의상 그대로.
- 모델과 예산은요? 기본: Seedance 2.5, 견적 합계를 먼저 보여 줌.
- 원본 음성을 그대로 쓸까요? 기본: 그대로.
에이전트가 하는 일
| 단계 | 에이전트가 하는 일 |
|---|---|
| 입력 확인 | 원본 길이, 프레임레이트, 컷 경계를 읽고 원본의 누가 어떤 시트로 바뀌는지 적습니다. 위치가 바뀌는 컷은 컷마다 배정을 적습니다. |
| 구간 나누기 | 원본을 7초 안팎 구간으로 나누되 0.5–1초씩 겹치게, 경계는 컷 경계 근처에 둡니다. 각 구간을 참조 영상으로 내보냅니다. |
| 구간별 생성 | 참조 영상과 시트들을 붙여 구간마다 무음으로 생성합니다. 같은 구간의 다른 테이크도 지우지 않고 보관합니다. |
| 조립 | V1 원본(불투명도 0, 맞춤 기준), A1 원본 음성, V2 보조 테이크, V3 주 테이크로 쌓습니다. 생성본은 컷이 약 5프레임 빠르게 나와서 뒤로 밉니다. |
| 속도 맞춤 | 기본은 1.0배속으로 위치만 맞춥니다. 어긋나는 긴 구간만 나눠 0.94–1.06배 안에서 보정합니다. |
| 구간 대체 | 원본과 어긋나기 시작하는 시점에서 주 테이크를 잘라 내면 아래 보조 테이크가 보입니다. |
| 검수 | 컷 경계와 구간 중간 15–20개 시점을 원본과 비교하고, 검은 빈 프레임이 없는지 확인한 뒤 내보냅니다. |
이 스킬의 핵심: 주 테이크와 보조 테이크를 겹친다
생성 구간은 뒷부분으로 갈수록 원본과 어긋나기 쉽습니다. 좌우 인물 배정이 뒤바뀌거나 동작이 흐트러집니다. 그래서 스킬은 같은 구간의 다른 테이크를 버리지 않고 아래 트랙(V2)에 깔아 둡니다.
- 위 트랙(V3)의 주 테이크가 원본과 어긋나기 시작하는 시점을 찾습니다.
- 그 시점에서 주 테이크를 잘라 내면, 잘린 자리에 아래의 보조 테이크가 그대로 보입니다.
- 2초 안팎의 짧은 구간이면 보조 테이크의 배속이 1.0이 아니어도(예: 약 1.26배) 동작과 배정이 원본과 맞는 쪽을 씁니다.
- 모든 테이크가 어긋날 때만 그 구간을 새로 생성합니다. 이때는 비용이 드니 견적부터 봅니다.
스킬에 적힌 사례는 0.167–4.733초를 주 테이크, 4.733–6.7초를 보조 테이크, 6.7초 이후를 다시 주 테이크로 이어 붙였습니다.
배속을 크게 바꿔 맞추면 영상이 끊기거나 버벅이는 것처럼 보입니다. 그래서 기본은 1.0배속 위치 맞춤이고, 0.94–1.06배로도 안 맞는 구간은 배속 대신 테이크 대체나 재생성으로 해결합니다.
스킬 파일 전문
다운로드한 파일과 같은 내용입니다. 복사해서 새 파일로 저장해도 됩니다.
---
name: multicut-dance-multi-swap
description: 여러 컷으로 된 댄스 영상에서 인물 2명 이상을 각각 지정한 인물/캐릭터 시트로 교체하고, AI 생성은 무음으로 한 뒤 원본 음성을 편집기에서 합쳐 완성본을 만든다.
version: 1.1
---

# 멀티컷 댄스 영상 다인물 교체 (무음 생성 + 원본 음성 합성)

## 적용 조건
- 원본 댄스/퍼포먼스 영상 1개 + 교체할 인물별 참조 시트(인물시트, 캐릭터 시트) 2개 이상이 있다.
- "인물 교체", "캐릭터로 바꿔", "원본 음성 유지" 같은 요청.
- 음성/음악은 원본 그대로 써야 한다(모델 음성 출력 금지).
- 해당하지 않으면 이 스킬을 쓰지 않는다.

## 시작 전에 사용자에게 묻기
이 스킬의 목적은 예시와 똑같은 영상을 다시 만드는 것이 아니라, 사용자만의 영상을 만드는 것이다. 작업을 시작하기 전에 아래 질문을 한 번에 묶어 묻는다.
- 요청에 이미 답이 있는 항목은 묻지 않는다.
- 사용자가 "알아서", "기본값으로"라고 하면 괄호 안 기본값으로 진행한다.
- 아이디어가 없어 보이면 예시와 다른 선택지 2–3개를 짧게 제안한다.
- 답을 받으면 확정한 내용을 한 줄로 요약해 보여 주고 시작한다.

1. 바꿀 사람은 몇 명이고, 각자 어떤 캐릭터(시트)로 바꿀까요?
2. 원본에서 누가 누구인지 위치나 의상으로 알려 주세요.
3. 의상이나 소품을 바꾸고 싶은 것이 있나요? (기본: 시트의 의상 그대로)
4. 모델과 예산은요? (기본: Seedance 2.5, 견적 합계를 먼저 보여 줌)
5. 원본 음성을 그대로 쓸까요? (기본: 그대로)

## 입력 확인
1. 원본 영상 fileId, 길이, 프레임레이트(get_editor_context frameRate), 컷 경계 시점.
2. 인물 배정: 원본의 누구(좌/우, 의상 등) → 어떤 시트인지. 화면 위치가 바뀌는 컷이 있으면 컷마다 배정을 적어 둔다.
3. 모델과 예산. 지정이 없으면 사용자에게 묻는다.

## 1. 원본 구간 나누기
- 원본을 7초 안팎 구간으로 나눈다(예: 0–7, 6.2–13.2, 끝 4초). 구간은 0.5–1초씩 겹치게 잡는다.
- 구간 경계는 컷 경계 근처에 둔다. 동작 한가운데에서 자르지 않는다.
- 각 구간을 편집기에서 범위 내보내기(export_draft start/end)로 참조 영상 파일로 만든다.

## 2. 구간별 생성 (무음)
- 모델: 사용자가 지정한 모델(예: Seedance 2.5).
- configs: resolution 1080p, aspectRatio 16:9(원본 비율), duration = 구간 길이, **generateAudio: false**.
- attachmentIds: [구간 참조 영상, 인물시트 A, 인물시트 B].
- 프롬프트: "참조 영상의 카메라·컷·안무·타이밍을 프레임 단위로 그대로 유지. 왼쪽(또는 ○○ 의상) 인물 → 시트 A, 오른쪽 인물 → 시트 B. 배경·조명·카메라 유지. 컷 순서와 길이 변경 금지. 음성 없음."
- 견적 → maxCredits = 견적값으로 시작. 견적 도구가 실패하면 maxCredits를 작게 넣어 거절 응답의 견적을 확인하는 방법도 있다(생성되지 않음).
- 같은 구간도 **다른 테이크(이전 생성본, 전체 1회 생성본 등)를 지우지 말고 보관**한다. 5단계에서 대체 소스로 쓴다.

## 3. 타임라인 조립 (레이어 구조)
- V1: 원본 영상, 불투명도 0. 맞춤 기준이며 화면에는 보이지 않음.
- A1: 원본 음성 1.0. 생성본 소리는 쓰지 않는다.
- V2: 보조 테이크(이전 생성본 등). V3에 빈 곳이 생기면 이 트랙이 보인다.
- V3: 주 테이크(구간별 재생성본).
- 모든 생성 클립은 scale을 맞춰 가장자리 검은 테두리를 없앤다(예: 1.0032).
- 생성본은 컷이 약 5프레임 일찍 나오는 경향이 있다. 원본 컷 경계에 맞춰 +5프레임 정도 뒤로 둔다(move_clips deltaFrames).

## 4. 속도 맞춤
- 기본은 **1.0배속 위치 맞춤**. 배속을 크게 바꾸면 끊기거나 버벅이는 것처럼 보인다.
- 원본과 어긋나는 긴 구간만 split_clip으로 나눠 0.94–1.06배 안에서 보정한다.
- 그 범위로 안 맞는 구간은 배속을 더 바꾸지 말고 5단계 대체 또는 재생성으로 해결한다.

## 5. 문제 구간 잘라 내고 대체 (v1.1 추가)
- 생성 구간은 **뒷부분일수록 원본과 어긋나기 쉽다**(인물 좌우 배정 뒤바뀜, 동작 흐트러짐 등).
- 원본(V1 불투명도를 잠시 올리거나 원본 파일 프레임)과 대조해 어긋나기 시작하는 시점을 찾는다.
- 그 시점에서 V3 클립을 trim_clip으로 잘라 낸다. 잘린 자리는 V2 보조 테이크가 그대로 보인다.
- 짧은 구간(2초 안팎)이면 보조 테이크의 배속이 1.0이 아니어도(예: 약 1.26배) 동작·배정이 원본과 맞는 쪽을 쓴다.
- 모든 테이크가 어긋날 때만 그 구간을 새로 생성한다(비용 발생 → 견적 먼저).
- 사례: 0.167–4.733초는 주 테이크, 4.733–6.7초는 보조 테이크, 6.7초 이후는 다시 주 테이크.

## 6. 검수
- 편집기에서 컷 경계와 각 구간 중간을 포함해 15–20개 시점을 원본 프레임과 비교한다(inspect_app_media times).
  - 확인 항목: 컷 타이밍(±2프레임), 인물 배정(좌/우), 동작 일치, 얼굴·의상이 시트와 일치하는지, 가장자리 테두리.
- 어긋난 시점이 나오면 4–5단계로 고치고 다시 확인한다.
- 생성 클립 사이 빈 프레임(검은 화면)이 없는지 타임라인 수치로 확인한다.

## 7. 내보내기와 마무리
- export_draft로 MP4를 내보내 결과 폴더에 저장하고, 결과 파일로 다시 여러 시점을 확인한다.
- 이름: `{프로젝트}_인물교체_완성본_원본음성_vN.mp4`.
- 상태는 검토 필요(review). 승인됨은 사람만 지정한다.
- 작업 메모 댓글: 사용 모델·설정·프롬프트·구간·참조·대체 구간·실제 청구 크레딧·남은 확인 사항.
- 소리 싱크(노래와 동작)는 도구로 들을 수 없으면 사람이 들어 보도록 보고에 남긴다.

## 비용 기록
- 구간별 견적과 실제 청구(get_ai_generation_status billedCredits)를 따로 적는다.
- 참고: 1080p 7초 약 462, 4초 약 250 크레딧(2026-10 기준, 실제 견적이 우선).

## 변경 기록
- 2026-10-19 시작 전 질문 추가.
- v1.1: 사용자 최종본(완성본 v1) 방식 반영. 주/보조 테이크를 겹치는 트랙 구조, 문제 구간을 잘라 내고 보조 테이크로 대체하는 단계(5단계) 추가, 짧은 대체 구간의 배속 예외 명시.
- v1.0: 구간 생성 + 1.0배속 위치 맞춤 + 원본 대조 검수(에이전트 v3 기준).
실행 전에 알아둘 팁
- 원본 영상과 캐릭터의 권리를 꼭 확인하세요. 방송이나 공연 영상은 방송사와 제작사의 저작물이고, 음악에도 저작권이 있습니다. 예시의 개구리 캐릭터는 작가 Matt Furie의 저작권 캐릭터 페페(Pepe the Frog)입니다. 이미 있는 캐릭터를 쓸 때는 사용 범위를 확인하고, 상업적으로 쓰려면 권리자의 허락이 필요합니다.
- 사람은 본인, 동의한 사람, 가상 캐릭터만 쓰세요. 예시의 인물도 프로젝트의 가상 인물입니다.
- 배정을 분명하게 적으세요. 왼쪽·오른쪽 대신 의상으로 구별하면 위치가 바뀌는 컷에서도 덜 헷갈립니다.
- 크레딧은 구간 수만큼 듭니다. 스킬에 적힌 참고값은 1080p 7초 약 462, 4초 약 250 크레딧입니다(2026년 10월 기준). 실제 크레딧은 에이전트가 견적으로 먼저 확인합니다.
- 노래와 동작의 싱크는 직접 들어 보세요. 에이전트는 화면으로 동작을 비교하지만 소리는 사람이 들어야 한다고 보고합니다.
자주 묻는 질문
세 명 이상도 바꿀 수 있나요?
됩니다. 바꿀 사람마다 시트를 한 장씩 붙이고, 누가 어떤 시트인지 적으면 됩니다. 사람이 많을수록 배정이 뒤바뀌기 쉬워서 검수 시점을 늘리는 것이 좋습니다.
한 사람만 바꾸려면요?
한 사람만 바꾸는 댄스 영상은 댄스 영상 인물 교체, 대사가 있는 실사 영상은 드라마 인물 교체가 맞습니다.
이전에 만든 테이크는 지워도 되나요?
지우지 마세요. 이 스킬은 이전 테이크를 어긋난 구간의 대체 소스로 씁니다. 같은 구간의 테이크가 많을수록 다시 생성하지 않고 고칠 수 있는 경우가 늘어납니다.
YouViCo에서 이 스킬 실행하기
프로젝트에 사진을 올리고 AI 에이전트 채팅창에 스킬 파일을 첨부한 뒤 영상을 만들어 달라고 요청하세요.